星尘智能发布能异步执行的在线强化学习框架 SmoothRL 当前信息
 (资料图片仅供参考)
9月4日消息,近日,星尘智能基座模型团队发布能异步执行的在线强化学习框架SmoothRL(Online Reinforcement Learning During Asynchronous Execution)。该框架针对的是大模型异步推理成为真实部署常态后,online RL 应从哪些动作里学习的问题。技术报告已在星尘智能官网发布。
SmoothRL要解决的问题,由异步推理与online RL 的节奏错配引发。VLA、World-Action Model等机器人基础模型普遍采用action chunk,即一次生成未来一段时间的动作序列。但模型越大推理越慢,机器人不能每几百毫秒就停下来等下一段推理,尤其在投掷这类高动态任务中,一次停顿就可能让已积累的速度归零。因此真实部署多采用异步推理:机器人继续执行手头的动作,模型同时计算下一段。
图注:SmoothRL 整体框架:机器人在异步执行中持续产生真实数据,基础策略提供通用能力,在线 RL 会根据真实执行结果更新动作策略。
这种部署方式让"模型计划过"和"机器人真正做过"的动作不再完全对应。SmoothRL把一段action chunk按执行状态切成三个区域:已提交区域(committed region,已被上一轮推理锁定不可改)、执行区域(execution region,机器人当前轮实际执行的动作)、丢弃区域(discarded region,会被下一轮推理替换)。SmoothRL的核心是只对执行区域计算梯度——机器人真正做了什么,就只对什么做强化学习。
SmoothRL团队的另一项原则是"Reinforce in Deployment(在部署强化学习)",也就是在训练阶段就使用异步推理,replay buffer记录的是真实时间关系下的轨迹,而不是先在同步环境里训练好再切换到异步部署。
据论文披露的实现细节,团队采用针对各任务微调后的π0.5作为基础策略,沿用RLT骨架,用轻量TD3-style actor-critic在原始动作空间预测residual correction。星尘S1机器人以30Hz执行动作,推理请求频率为5Hz,即每200ms得到一个新的action chunk;基础策略每次预测32帧动作,在固定延迟预算下,Committed与Execution共占12帧,其中6帧属于本轮真正执行的Execution Region。
在绳驱本体星尘智能S1的真机任务上,三项任务的基线成功率均明显提升。动态投掷成功率从39%升至94%(250个rollout episodes),考验的是机器人在摆动中持续加速并在准确时刻释放的能力;给笔戴帽从8%升至83%,双臂需将相对位姿误差控制在约5mm以内;快递开箱从30%升至90%,机器人需将1mm宽刀片插入2—3mm宽的箱盖接缝。三项任务存在系统性偏差(投掷释放速度不准、开箱刀片左偏、戴帽动作过于相似),在线RL的功能是按真实执行结果将这些偏差修回。(袁宁)
- 观焦点:四川旺苍探索光伏产业后端利用新赛道 退役光伏组件成循环利用"香饽饽" 一大早,四川旺苍经济开发区,永安光循环保科技股份有限公司标准化生产车间内一派繁忙。一张张退役光伏板从料口“喂”入,不到一分钟,经过自动化精细拆解为7种再生材料,
- 国家医保局:加大创新药械和创新服务支持力度 推动中国医药走出去_每日资讯 中新经纬9月4日电国家医保局副局长施子海表示,将加大对创新药械和创新服务支持力度,推动中国医药走出去。4日,国新办就推进医保高质量发展、更好服务中国式现代化建
- 名创优品(09896.HK)9月3日耗资24.72万美元回购10.24万股_热推荐 格隆汇9月4日丨名创优品(09896.HK)公告,9月3日耗资24.72万美元回购10.24万股,每股回购价2.39-2.4275美元。
- 星尘智能发布能异步执行的在线强化学习框架 SmoothRL 当前信息 星尘智能发布能异步执行的在线强化学习框架SmoothRL,强化学习,机器人,星尘,推理,smoothrl
- 【活力中国调研行】黑土地会“说话”,他们听了40多年 【活力中国调研行】黑土地会“说话”,他们听了40多年,黑土地,李艳华,大豆,黑土
- 前沿资讯!千问办公上线首月用户数超3000万 千问办公上线首月用户数超3000万,用户数,阿里巴巴,千问办公,活跃用户,知名企业
- 热议:建投能源Q2利润腰斩但新机组年内投产 装机扩张对冲短期压力 CFi.CN讯:数据显示,建投能源2026年上半年营收102.31亿元、归母净利润7.77亿元,分别同比下降7.94%和13.41%;其中二季度净利润仅1.77
- 多个城市楼市新政密集落地 “金九银十”现苗头 9月,楼市进入传统的“金九银十”旺季。随着多个城市的楼市新政密集落地,市场热度有望攀升。
- 动态:扬电科技:全资子公司已依约完成32个算力节点的交付并验收通过 证券之星消息,扬电科技(301012)09月03日在投资者关系平台上答复投资者关心的问题。
- A股早评:三大指数集体高开,贵金属、无人驾驶概念盘初活跃 信息 A股开盘,三大指数集体高开,沪指涨0.34%报3955.55点,深证成指涨0.71%,创业板指涨0.97%。盘面上,贵金属、无人驾驶概念盘初活跃,农业股普遍低开。
- 广发创业板算力基础设施ETF开启认购 看点 ,证券时报网
- 今头条!苏州固锝:融资净买入188.06万元,融资余额4.98亿元 交易所最新数据显示,苏州固锝于2026年9月3日获融资买入1558.68万元,融资偿还1370.62万元,当日融资净买入188.06万元。目前,该股融资余额4.98亿,占流通市值比例为6.79%。该股
- 鸿路钢构:融资净偿还525.84万元,融资余额6429.4万元 每日关注 交易所最新数据显示,鸿路钢构于2026年9月3日获融资买入602.91万元,融资偿还1128.75万元,当日融资净偿还525.84万元。目前,该股融资余额6429.40万,占流通市值比例为0.62%。
- 9月3日科创半导体设备ETF鹏华基金份额增加3200万份,重仓股华海清科、中微公司、中科飞测 证券之星消息,9月3日,科创半导体设备ETF鹏华基金(589020)最新份额为45.24亿份,较前一交易日增加了3200.0万份。
- 9月3日科创50ETF富国基金份额增加4200万份,重仓股寒武纪、澜起科技、中微公司 证券之星消息,9月3日,科创50ETF富国基金(588940)最新份额为29.79亿份,较前一交易日增加了4200.0万份。
- 9月3日科创新能源ETF鹏华基金份额增加700万份,重仓股海博思创、微导纳米、嘉元科技 证券之星消息,9月3日,科创新能源ETF鹏华基金(588830)最新份额为6.02亿份,较前一交易日增加了700.0万份。
- 【ETF观察】9月3日宽基指数ETF净流入36.59亿元 ,证券之星ETF
- 科伦博泰生物(06990.HK)获汇添富基金增持3.08万股 ,格隆汇
- 帝王实业控股(01950.HK):孙方宇及邱城盛获委任为独立非执行董事 帝王实业控股(01950.HK)发布公告,于2026年9月3日,黄振明先生及周筱春女士因有意投放更多时间于彼等之其他事务而提出辞任独立非执行董事,自2026年9月3日起生效。
- 【聚看点】创业集团控股(02221.HK)拟发行1489.49万股收购目标公司70%股权 创业集团控股(02221.HK)拟发行1489.49万股收购目标公司70%股权
热门资讯
-
 中国信达北京5宗违法合计遭罚250万 借新还旧掩盖不良
银保监会网站昨日公布的北京银保监局行政处罚信息公开表(京银保监罚决字〔2020〕19号)显示,中国信达(0...
-
 进一步推进广东自贸区外汇管理改革试点实施细则发布
中新网广州1月17日电 (记者 许青青)记者1月17日从中国(广东)自由贸易试验区工作办公室(广东自贸办)...
-
 年关已到,协同执行机制“发威”,56名工人领到被欠工资
老板跑了,本以为辛辛苦苦的工钱就这么打水漂,没想到年前讨回了血汗钱。1月16日,7位工人代表从深圳专程赶来...
-
 区块链发展堪忧 沪深交易所接连出手平抑
1月16日晚间,上交所发布公告称,高度重视区块链概念炒作,并第一时间组织分析研判,认为区块链技术仍处于开发...
文章排行
图片新闻
-
 最低工资标准上调窗口开启 陕西上海重庆已调整
最低工资标准的调整关系到每个人的钱袋子。据中国网财经记者梳理,今年以来,重庆、上海、陕西等地已经上调最低工...
-
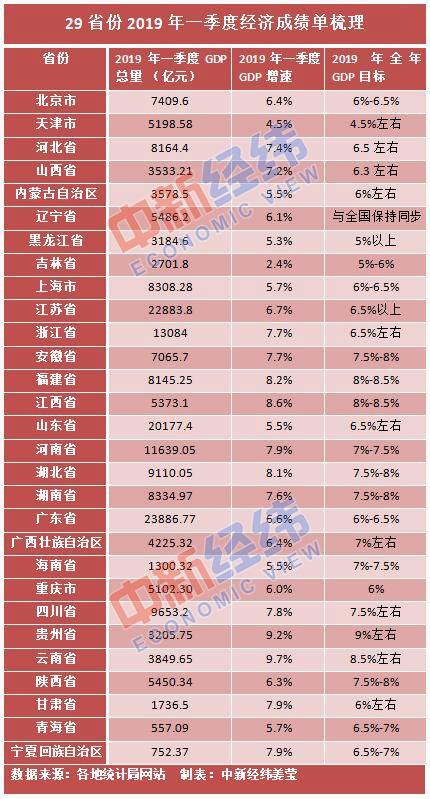 29省份晒一季度经济成绩单:16省份经济增速跑赢全国 5省份迈入“万亿俱乐部”
29省份晒一季度经济成绩单:16地跑赢全国截至目前,共有29省份公布一季度经济数据成绩单。其中,16省份G...
-
天安财险旗下保险销售公司收60万罚单:存在编制虚假资料行为 7月16日,北京银保监局发布2020年第25号行政处罚信息公开表,处罚涉及天安佰盈保险销售有限公司以及法定...
-
 上市梦碎,“面爷爷”“面奶奶”流落街头,开封百年老字号,我们拿什么来拯救你?
老字号传承并延续着一个城市的商业文脉。可以有老建筑,可以有老商业街,可以有老匠人,每一个日新月异的城市,怎...